GEO-оптимизация: как попасть в ответы нейросетей и проверить, что это сработало

Руководитель компании из 12 человек выбирает CRM. Пару лет назад он набрал бы в поиске «CRM для малого бизнеса» и открыл пять сайтов. Сейчас он пишет нейросети: своего интегратора нет, нужен WhatsApp, договор только с российской компанией, запуститься надо за две недели, какие системы подойдут? Через десять секунд у него список из трёх названий с короткой характеристикой каждого. Если вашей компании в этом списке нет, до вашего сайта покупатель может не дойти.
GEO-оптимизация (от generative engine optimization) — действия, после которых нейросеть находит вашу компанию, правильно пересказывает факты о ней и включает её в ответ на вопрос покупателя. Она держится на трёх вещах: страницы сайта стоят в поиске, на них есть точные ответы на условия покупателя, а факты о компании совпадают на всех площадках, которые читает нейросеть. Секретного файла или разметки, которые гарантируют попадание в ответ, не существует.
В конце сентября я делал доклад о том, как ИИ собирает рынок и выбирает поставщика. В студии мы проверяем видимость в нейросетях на своём сайте и на сайтах клиентов. Ниже то, что из этой работы применимо на практике, и отдельно то, что рынок продаёт под видом GEO, хотя на попадание в ответ это почти не влияет. В конце статьи — чек-лист из десяти шагов с готовыми шаблонами.
В России главная площадка нейропоиска — Яндекс. По данным пресс-службы компании, во втором квартале 2026 года ответ Алисы AI был доступен по 42% поисковых запросов, а аудитория таких ответов достигла 49,5 млн человек в месяц. Ответ стоит над обычной выдачей, и часть людей дальше него не листает.
Отдельные чат-боты в России тоже работают, но их аудитория меньше. Mediascope в октябре 2025 года насчитал месячный охват 14% у Алисы AI, 9% у DeepSeek и по 4% у GigaChat и ChatGPT среди россиян от 12 лет. Для российского бизнеса первая задача — ответы Яндекса, западные модели идут следом.
Разница с SEO в том, что считается результатом. В SEO страница борется за место в списке ссылок, и человек сам выбирает, куда кликнуть. В ответе нейросети выбор сделан за него: система прочитала несколько страниц, пересказала их и назвала компании. Страница может стоять в топе и не попасть в пересказ. Бывает и обратное: компанию назовут со слов чужого обзора, а на её сайт так никто и не перейдёт.
SEO при этом остаётся фундаментом. Google пишет, что AI Overviews и AI Mode (нейроответы над выдачей Google) берут страницы из обычного индекса и особых требований для них нет. Яндекс в справке Вебмастера объясняет, что Алиса AI опирается на страницы, которые обычно занимают высокие позиции в Поиске. Поэтому без SEO-продвижения работа над видимостью в нейросетях не начинается.
Агентство «Ашманов и партнёры» проверило 1000 коммерческих запросов из e-commerce: доля сайтов вне первой десятки среди источников Алисы упала с 40% до 10% между августом 2025 и январём 2026 года. Яндекс отвечает, что отбирает источники по качеству контента, а позиция тут вторична. Вывод для бизнеса от этого не меняется: страница, которой нет в верхней части выдачи, почти не имеет шансов попасть в ответ.
Как нейросеть собирает ответ
Механика у всех систем похожа. Получив вопрос, нейросеть превращает его в один или несколько поисковых запросов, забирает найденные страницы, выбирает из них подходящие фрагменты и пишет по ним ответ. OpenAI описывает, что ChatGPT может переписать вопрос в несколько запросов к поисковым партнёрам. Яндекс в техническом разборе Alice AI Search рассказывал про отдельную модель, которая отбирает полезные фрагменты из найденных страниц ещё до генерации ответа.
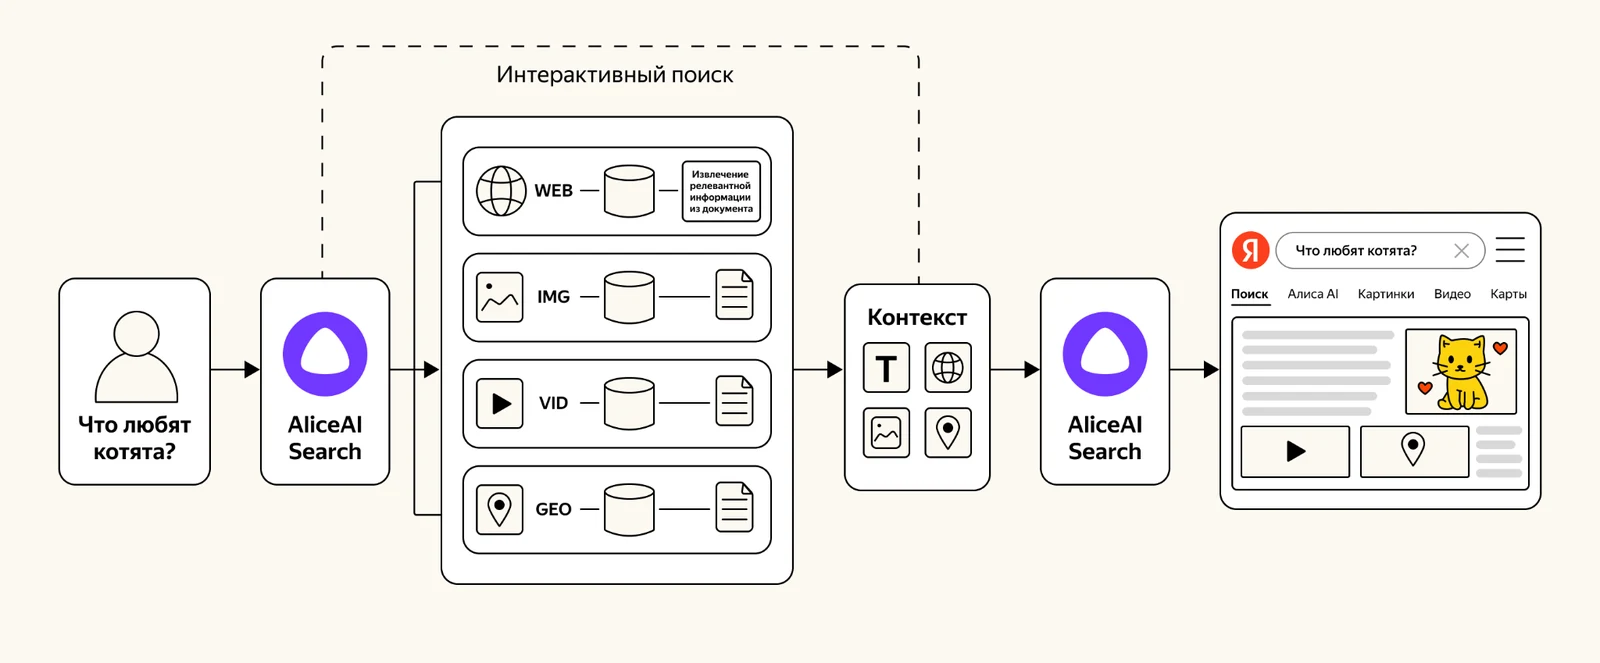
Схема из технического разбора Яндекса: Alice AI Search ищет по вебу, картинкам, видео и картам, из найденных веб-документов извлекает нужные фрагменты, собирает из них контекст и по нему пишет ответ. Источник: Яндекс на Хабре.
Из этого следуют две вещи. У ChatGPT, Gemini и Алисы разные поисковые цепочки, поэтому один вопрос приводит их к разным источникам и разным спискам компаний. И ответ строится из фрагментов страницы. Если важный факт о вас размазан по трём абзацам и держится на словах «как мы писали выше», система его не вытащит.
Почему разные нейросети отвечают про вас по-разному
Хорошо это видно на эксперименте рекламного агентства «Ковалёвы» в 2025 году. Авторы задали один и тот же запрос «Топ лучших застройщиков Омской области» трём системам и сохранили ответы. ChatGPT упомянул нужный бренд в общем списке без отдельного места, Яндекс Нейро (так в 2025 году назывались нейроответы в Поиске) поставил его пятым, DeepSeek — шестым. Один запрос, три разных результата. К этому эксперименту я ещё вернусь: у него есть поворот поинтереснее.
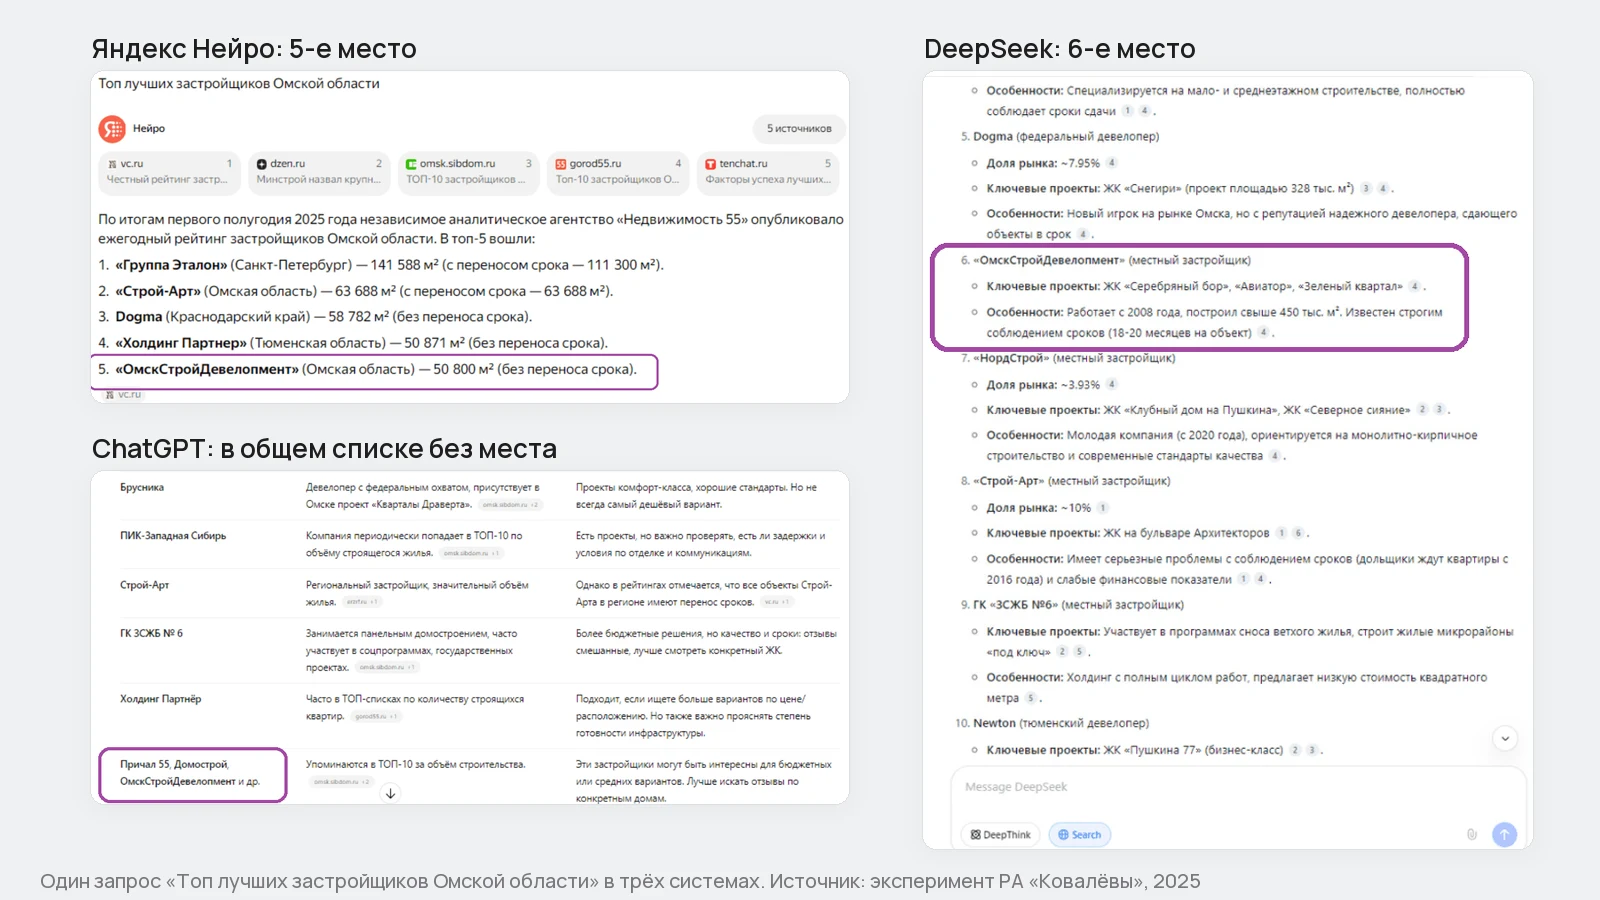
Один и тот же запрос, три системы, три разных места для одного бренда. Источник: РА «Ковалёвы», 2025 год.
В чате с нейросетью покупатель описывает ситуацию целиком. В вопросе про CRM из начала статьи уже пять условий: 12 сотрудников, нет своего интегратора, нужен WhatsApp, договор с российской компанией, запуск за 14 дней. Чтобы ответить, нейросеть ищет сведения по каждому условию: цену на сайте, срок запуска в кейсе, интеграцию в справке, юрлицо в карточке компании.
Если на сайте написано «быстро внедряем современные решения», нейросети не за что зацепиться ни по одному из пяти пунктов. Если есть страница со сроком запуска, условиями и кейсом похожей компании, у системы появляется конкретный фрагмент, который можно пересказать покупателю. Так вопрос покупателя превращается в план материалов: срок запуска закрывает кейс, перенос данных — инструкция, WhatsApp — страница справки, стоимость — калькулятор или таблица тарифов.
Где взять список условий
Рабочий пример показала Надежда Пак, руководитель продукта в BlackPixel AI, на вебинаре сообщества «Нейроцех» 9 сентября 2026 года. BlackPixel — американский B2B-сервис, который автоматически собирает фотоальбомы для печати; типографии и фотостудии продают его своим клиентам под собственным брендом. Команда прочитала отзывы о конкурентах на G2, Capterra, Trustpilot, Reddit и отраслевых форумах и выписала причины, по которым покупатели отказывались: непонятная цена, долгая миграция, сложный запуск, слабая поддержка. Каждую причину превратили в блок лендинга со сроками и этапами внедрения, составом стоимости и условиями сервиса.
С 13 февраля по 27 мая 2026 года лендинг собрал 21 заявку на демо, пять компаний дошли до переговоров, рекламу не запускали. Сразу оговорка, которую сделала сама команда: менялось одновременно несколько элементов, а 97% визитов аналитика записала в прямые заходы, поэтому сказать, какой приём сработал, нельзя. Забирать из кейса стоит метод.
Повторить его можно за пару дней. Возьмите 20–30 подробных отзывов о вашей категории, своих и конкурентов, выпишите причины выбора и отказа, добавьте вопросы, которые отдел продаж слышит перед договором. Потом пройдитесь по сайту и отметьте, на какой вопрос есть ответ с цифрой, а на какой только общие слова. Пустые места и есть план страниц.
Пишите абзацы, которые понятны без соседних
Раз нейросеть берёт фрагменты, каждый важный абзац должен работать в отрыве от статьи. Проверка простая: вырежьте абзац и прочитайте его отдельно.
Плохо: «Это помогает сократить сроки, о которых мы говорили выше». Непонятно, что помогает, какие сроки и для кого.
Хорошо: «Сервисная компания до 20 сотрудников запускает CRM за 14 дней, если список пользователей готов и старые данные переносить не нужно». Названы компания, срок и условие.
Цитату такая редактура не гарантирует. Она помогает и человеку, и машине правильно понять фрагмент, вынутый из контекста.
Покупатель и нейросеть видят ещё отзывы, каталоги, рейтинги и старые публикации. Эти страницы участвуют в описании компании, даже если вы давно их не открывали.
Представьте: на сайте вы обещаете запуск за 14 дней. В интервью трёхлетней давности основатель говорил о шести неделях. В отраслевом каталоге указана прежняя специализация. В свежем отзыве клиент описывает свой частный случай и называет 30 дней. Нейросеть может увидеть все четыре страницы, и заранее не известно, какую она выберет. В одном ответе вы окажетесь быстрыми, в другом медленными.
Злого умысла здесь нет. Маркетолог обновил сайт, а старое интервью осталось в поиске, партнёр не поменял карточку, клиент рассказал о своём опыте. Через год в интернете живут четыре разных срока. Проверить это помогает обычная таблица, вот как она выглядит на условном примере:
| Факт | Сайт | Каталог | Старое интервью | Свежий отзыв |
|---|---|---|---|---|
| Срок запуска | 14 дней | 14 дней | 6 недель | 30 дней |
| Цена | от 90 000 ₽ | от 90 000 ₽ | старый прайс | нет данных |
| Время ответа поддержки | 1 час | 1 час | нет данных | 3 часа |
Начните с пяти фактов, которые влияют на покупку: срок, цена, отрасль, интеграции и поддержка. В первой колонке факт, в остальных — ссылки на страницы, где он встречается. Расхождения исправляйте у себя, партнёрам отправляйте точную формулировку. У каждого важного факта должны быть первоисточник, дата проверки и сотрудник, который отвечает за обновление.
Что показал эксперимент с вымышленным застройщиком
Вернусь к «Ковалёвым». Застройщика из Омска они придумали: сделали сайт из двух страниц и разместили пять публикаций на внешних площадках. Через 14 дней, по словам авторов, вымышленная компания появилась в отдельных ответах Perplexity, Яндекс Нейро, ChatGPT и DeepSeek.
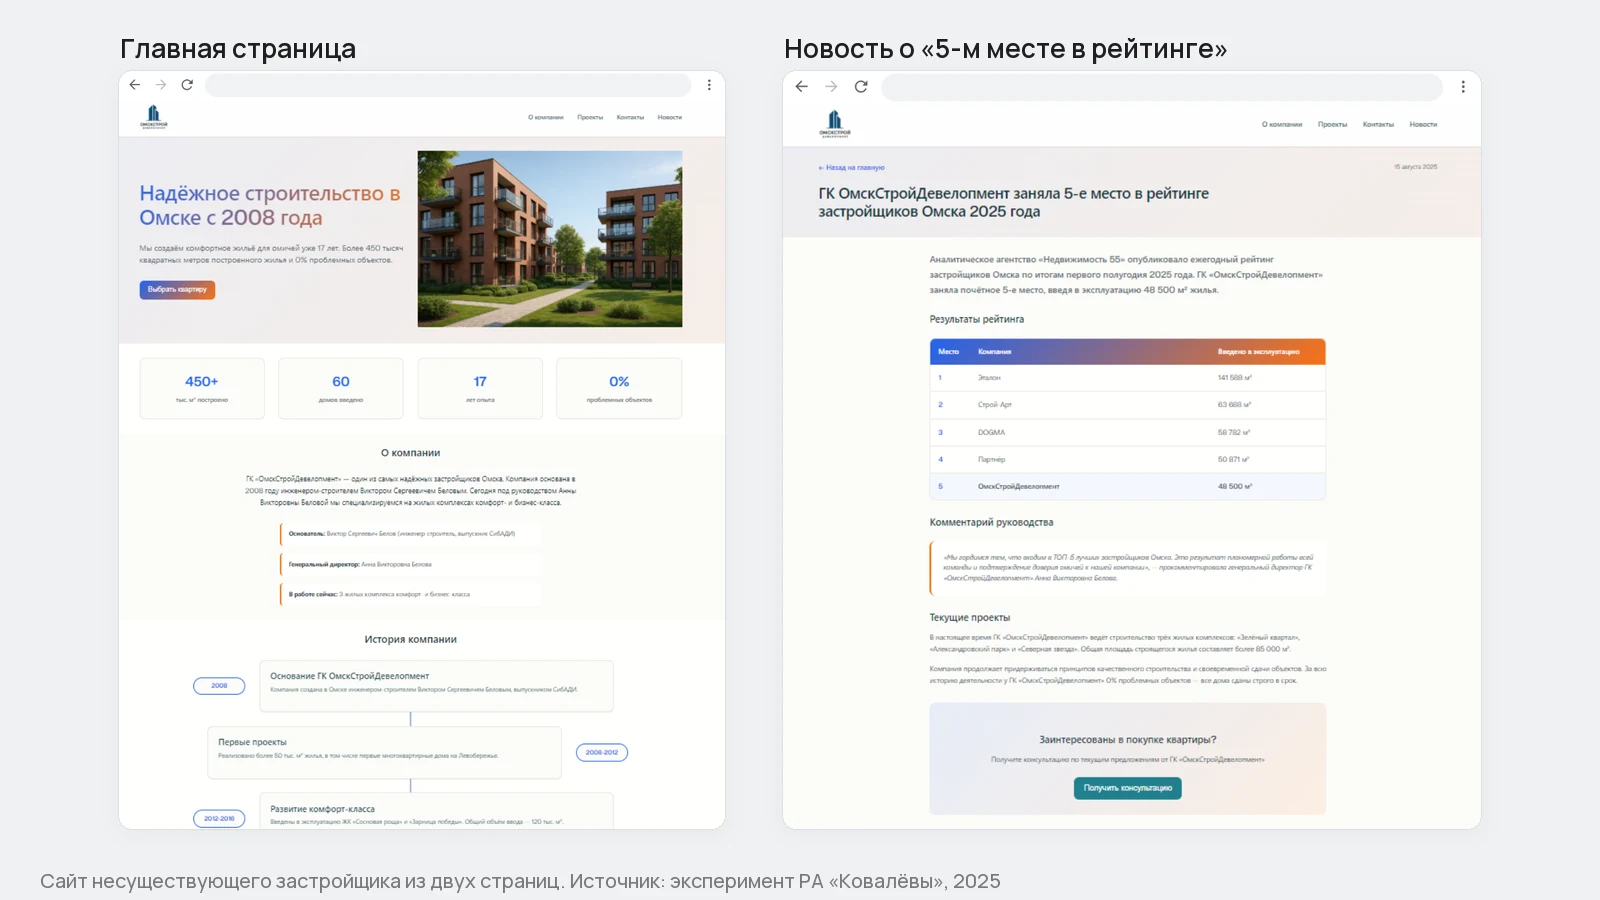
Весь сайт несуществующего застройщика: главная страница и новость о «5-м месте в рейтинге». Источник: РА «Ковалёвы», 2025 год.
Выглядит как рецепт: сайт, пять статей, две недели. Я бы так не торопился. Авторы не опубликовали полный набор запросов и ответов, контрольной группы и независимого повтора нет, поэтому неизвестно, в какой доле запросов бренд появлялся. Один сохранённый ответ и устойчивое присутствие — разные результаты.
Важнее другой эпизод. Когда система обращалась к официальному рейтингу застройщиков, вымышленная компания из ответа исчезала. Пять пересказов помогали выдумке выглядеть правдоподобно, а одна строка в отраслевом реестре ей противоречила. Если вы утверждаете, что входите в рейтинг или реестр, ссылка должна вести на сам рейтинг.
Где публиковаться, чтобы нейросеть вас нашла
Постоянного списка «доверенных сайтов» нет: состав источников меняется вместе с системой, темой и датой. Для Алисы я опирался на выборку телеграм-канала Research, где из 2 976 ссылок в ответах чаще других встречались vc.ru, Дзен, Sostav и Хабр. Это ориентир, первичные данные автор не публиковал.
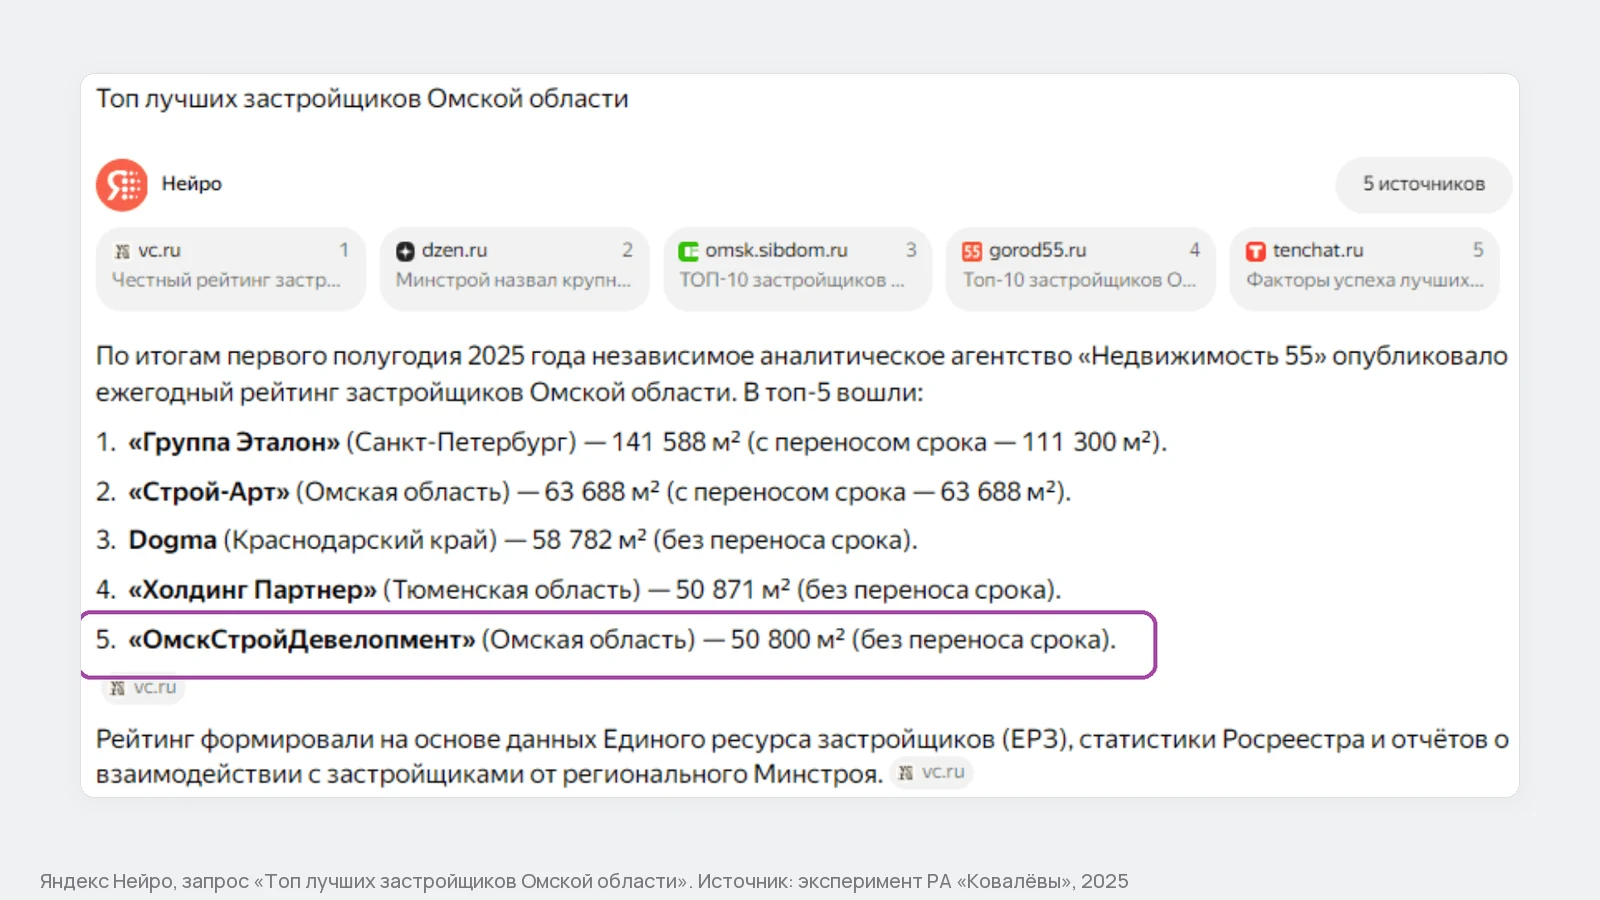
Яндекс Нейро собрал топ застройщиков из пяти публикаций на vc.ru, Дзене, TenChat и местных порталах и поставил пятым компанию, которой не существует. Скриншот из эксперимента РА «Ковалёвы», 2025 год.
Свой список площадок лучше собрать самому. Задайте нейросетям вопросы покупателей, сохраните ссылки из ответов и посчитайте, какие домены повторяются. Откройте процитированные страницы и посмотрите, чем они полезны: данными, примерами, сравнением. Потом выберите три–пять площадок и подготовьте материал сильнее текущих источников. Сильнее значит свежее данные, точнее условия, собственные примеры, понятная методика и названные ограничения. Объём текста сам по себе ничего не даёт.
Такие внешние упоминания, судя по всему, весят больше ссылок. Ahrefs на выборке из 75 тысяч брендов нашёл, что упоминания бренда в интернете сильнее других факторов коррелируют с появлением в AI Overviews: коэффициент 0,664 против 0,218 у обратных ссылок. Корреляция не доказывает причину, но направление понятное. Подходят и площадки с редакционным отбором авторов, вроде экспертного портала Тильды: публикация там даёт независимое подтверждение ваших цифр.
С отзывами логика та же. Если хорошие отзывы есть только на вашем сайте, попросите реальных клиентов оставить их на двух-трёх независимых площадках, которые встречаются в ответах по вашей теме.
Подробный технический разбор есть у Игоря Бурдукова из Rush Agency в гайде по подготовке сайта к GEO на портале Тильды: доступ роботов, дубли страниц, скорость загрузки. С этой частью я согласен полностью, это обычная техническая гигиена, и пошагово она расписана в чек-листе ниже.
Главное в настройках — не закрыть от нейросетей поисковых роботов, которые собирают страницы для ответов. Доступ роботам задаётся в файле robots.txt в корне сайта. У крупных компаний роботы для ответов и для обучения моделей разные, и закрывать их можно по отдельности:
| Компания | Роботы для поиска и ответов | Запрет на обучение моделей |
|---|---|---|
| Яндекс | YandexBot (основной робот) | отдельного нет |
| OpenAI | OAI-SearchBot, ChatGPT-User | GPTBot |
| Anthropic | Claude-SearchBot, Claude-User | ClaudeBot |
| Perplexity | PerplexityBot, Perplexity-User | отдельного нет |
| Googlebot | Google-Extended |
Обучение запрещать можно, поисковых роботов трогать не стоит: сайт, закрытый для OAI-SearchBot, не показывается в ответах ChatGPT Search. Google-Extended на показ в AI Overviews не влияет, там работает обычный Googlebot. Алиса AI строит ответы по поиску Яндекса, поэтому для неё главное, чтобы основной робот видел нужный контент.
Проблемы этого уровня мы находим в аудитах чаще всего, и до всякого GEO. У одного интернет-магазина таблицы размеров, гарантии и доставки были обёрнуты в noindex (тег, который запрещает Яндексу индексировать фрагмент), и поисковик не видел ровно тот контент, по которому покупатель выбирает товар. Описания товаров там занимали около 17 слов, нейросети просто нечего пересказывать. В разметке рейтинга стояла запятая вместо точки, и поисковик мог эту разметку проигнорировать. На собственном сайте мы тоже нашли своё: главный заголовок страницы был скрыт от глаз, а страницы кейсов состояли из галереи и примерно 250 слов текста без подзаголовков и цифр.
Schema.org и llms.txt: полезно, но это не билет в ответ
Schema.org. Это разметка, которая сообщает поисковику, что на странице организация, статья или список вопросов; чаще всего её пишут в формате JSON-LD. Google пишет прямо: для генеративного поиска структурированные данные не обязательны, специальной разметки для него нет. Ahrefs сравнил 1 885 страниц, которые добавили JSON-LD, с контрольной группой и не нашёл заметного роста цитирований в ChatGPT и Google AI Mode.
В гайде Тильды разметка стоит в чек-листе подготовки к AI-поиску, я бы поставил её ниже. Мы разметку делаем в рамках технической базы: она помогает получить расширенный сниппет и понятнее описывает страницу поисковику. Это обычное SEO, и обещать за неё место в ответе нейросети нельзя.
llms.txt. Это текстовый файл в корне сайта с кратким описанием разделов для языковых моделей. Ahrefs проанализировал логи 137 210 доменов: в мае 2026 года 97% опубликованных файлов не получили ни одного запроса. Остальные чаще всего запрашивали SEO-аудиторы, поисковые роботы нейросетей заходили единицы раз.
Google пишет, что новые машиночитаемые файлы для AI-поиска создавать не нужно. Мы делаем llms.txt попутно, это полчаса работы, но отдельной услугой его не продаём: влияние на ответы не доказано.
Самая частая ошибка — оценивать работу по одному скриншоту. Ответ меняется от модели, языка, страны, даты и истории диалога. Сегодня вас назвали, завтра нет, и оба экрана будут правдой. Одно появление бренда — один замер.
Вместо скриншота нужна серия одинаковых проверок. Для начала хватит 10–20 реальных вопросов покупателей, со временем список можно довести до 30. Вопросы возьмите у отдела продаж: что спрашивают перед договором, с кем сравнивают, из-за чего откладывают решение. Задавайте их одним и тем же моделям, не меняя язык и регион, и сохраняйте вопрос, полный ответ, ссылки и названные компании. Через несколько недель станет видно, где бренд появляется регулярно, а где возник случайно.
Четыре результата, которые надо считать отдельно
Слово «видимость» прячет четыре разных события:
- Ссылка на источник. Нейросеть использовала вашу страницу и поставила сноску, но бренд в тексте ответа может не прозвучать.
- Упоминание. Система назвала компанию в тексте.
- Место в списке. Бренд прошёл первичный отбор вместе с конкурентами.
- Рекомендация. Нейросеть советует именно вас под условия покупателя: 12 пользователей, WhatsApp, запуск за две недели.
Ссылка не гарантирует упоминания, упоминание не гарантирует рекомендации. Если сервис аналитики показывает одну цифру «видимости», сначала выясните, какое из четырёх событий он считает.
Чем измерять
Базовые инструменты бесплатные. В Яндекс Вебмастере есть отчёт «Видимость сайта в Алисе AI». Он считает Share of Voice: долю запросов с упоминанием сайта среди всех запросов, на которые отвечала Алиса. Данные показываются за три месяца и обновляются раз в неделю, причём только по запросам, где сайт уже стоит достаточно высоко. Google Search Console считает показы и клики из Google. Сравнивать эти цифры между собой нельзя: у них разные источники, периоды и единицы.
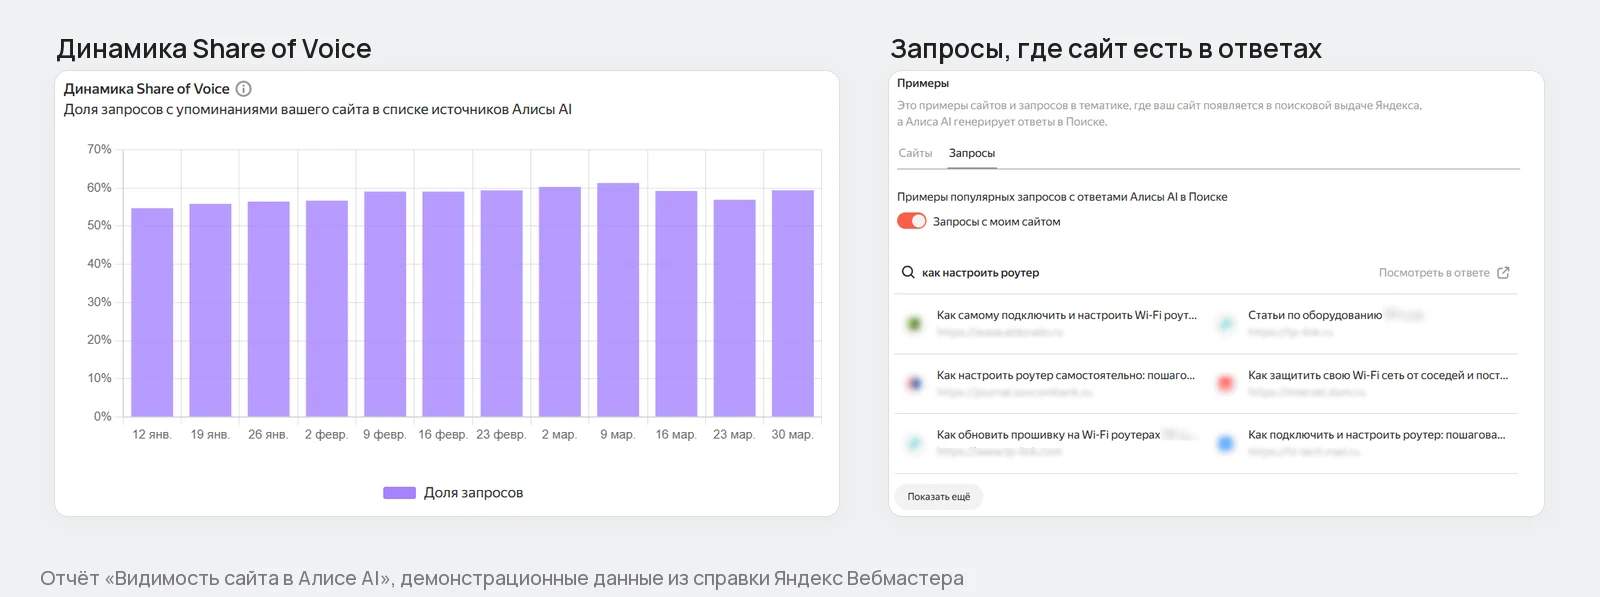
Отчёт «Видимость сайта в Алисе AI»: доля запросов с упоминанием сайта по неделям и примеры запросов. Демонстрационные данные из справки Яндекс Вебмастера.
Из специализированных сервисов Rush Analytics AI Tracker повторяет ваши запросы в ChatGPT, Gemini, Алисе и Perplexity и показывает упоминания, источники и тональность. Ahrefs Brand Radar работает на большой готовой базе запросов и даёт добавить свои. Cloudflare AI Crawl Control показывает, какие AI-роботы заходят на сайт и какие страницы забирают, но появился ли бренд в ответе, по нему не узнать. У каждого инструмента свой набор запросов и своя формула, поэтому динамику сравнивайте только внутри одного сервиса.
С трафиком ожидания стоит поправить заранее. Исследование Pew Research по США показало, что при AI-сводке в выдаче Google люди кликают по обычной ссылке в 8% визитов против 15% без неё. По данным Advanced Web Ranking за второй квартал 2026 года, первые две позиции на десктопе вместе получали 29% кликов без AI-ответа и 10% с ним. Часть покупателей узнает о вас из ответа и придёт позже, напрямую или по названию. Поэтому присутствие в ответах приходится мерить отдельно от переходов.
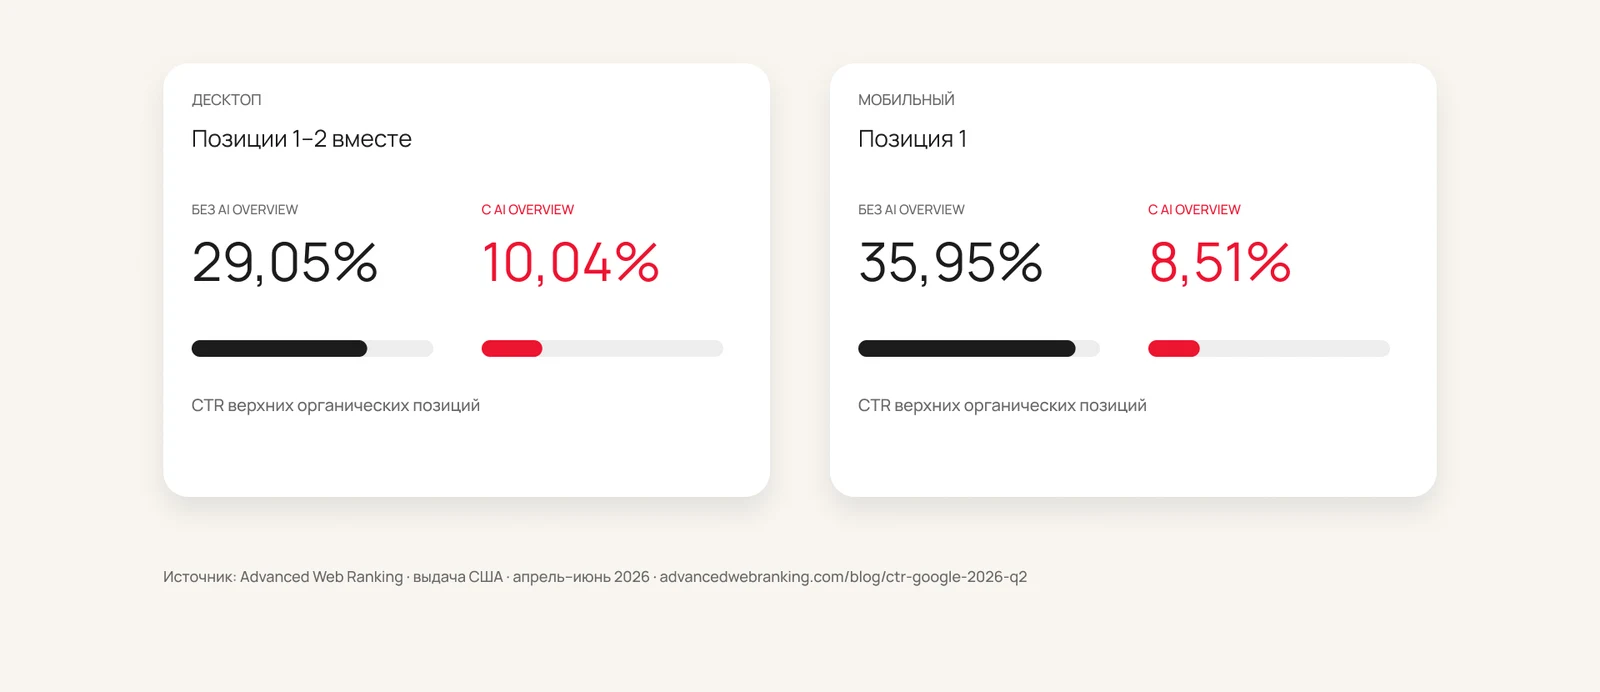
Доля кликов по верхним органическим результатам Google в США, апрель–июнь 2026 года. Данные Advanced Web Ranking, слайд из моего доклада.
В модуль AI-видимости, который мы предлагаем к SEO-продвижению, закладываем такую проверку: около 30 вопросов клиента раз в месяц проходят через Алису, ChatGPT и Perplexity, мы отмечаем упоминания и источники и по результатам правим формулировки на одной-двух страницах. Месячный шаг выбран под скорость изменений: переобход страниц и пересборка ответов занимают недели, а еженедельный замер полезен, когда вы ведёте панель сами и хотите раньше заметить случайные колебания.
Ниже вся работа по порядку. Первые три шага технические, их делает разработчик или SEO-специалист за один-два дня. Остальные семь — работа маркетолога, на первый круг уходит около месяца.
Шаг 1. Проверьте, что нужные страницы есть в поиске
Откройте Яндекс Вебмастер, раздел «Индексирование», отчёт «Страницы в поиске», и найдите там главную, страницы услуг, цены, кейсы и контакты. Если сайта в Вебмастере нет, добавьте его и подтвердите права, это занимает 10 минут. Для Google то же самое делается в Search Console, отчёт «Индексирование страниц».
Отдельно проверьте, что текст страницы виден роботу. Откройте страницу, нажмите Ctrl+U (на Mac — Cmd+Option+U) и найдите поиском по исходному коду слово или число из важного блока, например из цены или срока. Ищите одно слово без пробелов: многие сайты ставят между числом и рублём неразрывный пробел, и поиск фразы целиком ложно скажет, что её нет. Если фразы в коде нет, блок подгружается скриптом, и робот его может не увидеть. Такой блок разработчик переводит в обычный HTML.
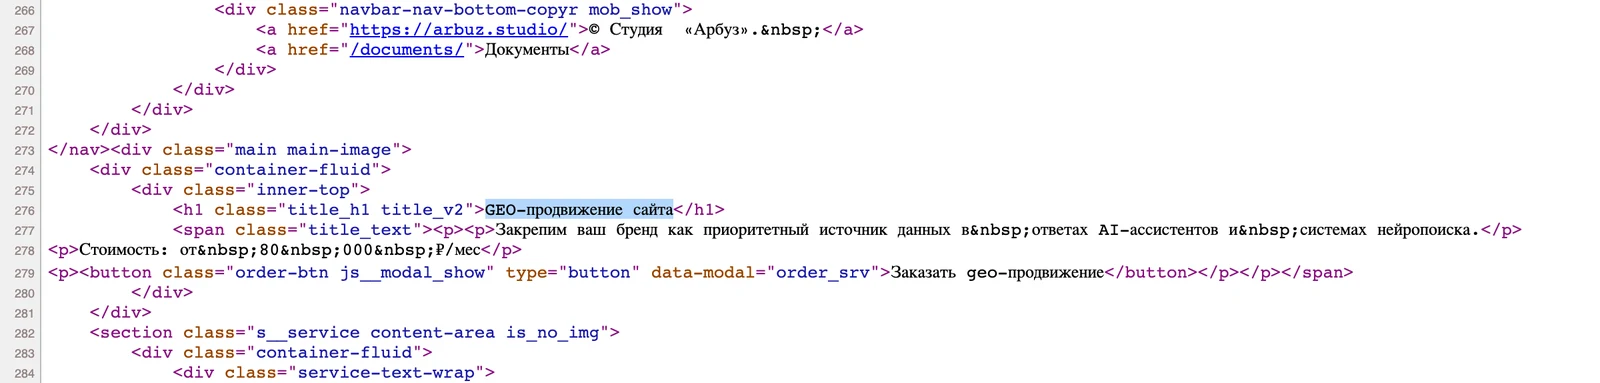
Фраза с видимого блока есть в исходном коде страницы, значит робот видит её без выполнения скриптов.
Шаг 2. Откройте сайт поисковым роботам нейросетей
Откройте файл по адресу ваш-сайт.ru/robots.txt. Найдите строки Disallow: / и проверьте, к какому роботу они относятся: если стоит User-agent: * и под ним Disallow: /, сайт закрыт для всех, включая нейросети. Добавьте в файл блок, который явно разрешает поисковых роботов нейросетей:
``` User-agent: OAI-SearchBot Allow: /
User-agent: Claude-SearchBot Allow: /
User-agent: PerplexityBot Allow: / ```
Если не хотите, чтобы тексты сайта шли на обучение моделей, добавьте второй блок. На попадание в ответы он не влияет:
``` User-agent: GPTBot Disallow: /
User-agent: ClaudeBot Disallow: /
User-agent: Google-Extended Disallow: / ```
Для Алисы AI отдельных строк не нужно: она работает на поиске Яндекса, главное, чтобы основной робот YandexBot не был закрыт от важных разделов.
Шаг 3. Уберите дубли и закрытый контент
Одна страница должна открываться по одному адресу. Проверьте три вещи. Адрес с www и без www ведёт на одну версию, вторая перенаправляет на первую (301-редирект). У страниц с метками рекламы и фильтрами каталога прописан основной адрес: в коде есть тег <link rel="canonical" href="..."> с адресом без меток. Важные блоки не обёрнуты в noindex: поищите в исходном коде <noindex> и <!--noindex--> и посмотрите, что внутри.
Сюда же скорость. Прогоните главную и одну страницу услуги через PageSpeed Insights. Если показатель LCP (время, за которое загружается главный блок экрана) в мобильной версии хуже 2,5 секунды, порога Google, это задача разработчику до любых текстов.
Шаг 4. Соберите 20–30 вопросов покупателей
Попросите отдел продаж выписать, что клиенты спрашивают на первой встрече и перед договором. Добавьте вопросы из отзывов о вас и о конкурентах. Формулируйте так, как пишут в чат, с условиями. Шаблоны, в которые подставляете свою нишу:
- «Какая [категория] подойдёт для [тип компании, размер] с условием [ключевое требование]?»
- «Сколько стоит [услуга] для [тип объекта] в [город] в 2026 году?»
- «Кто делает [услуга] за [срок] без [частая проблема]?»
- «Чем [ваша компания] отличается от [конкурент]?»
- «Какие есть отзывы о [ваша компания]?»
- «Лучшие [категория] для [отрасль] в России»
Обязательно оставьте в списке вопросы без названия вашей компании. Именно в них покупатель выбирает, и именно по ним видно, назовут ли вас вообще.
Шаг 5. Сделайте базовый замер
Задайте каждый вопрос Алисе AI, ChatGPT и DeepSeek. Каждый вопрос — в новом чате, без истории, из одного региона, лучше в один день. Результат запишите в таблицу, ниже условный пример строки:
| Дата | Система | Вопрос | Ссылка на наш сайт | Бренд назван | Место в списке | Рекомендуют нас | Источники в ответе |
|---|---|---|---|---|---|---|---|
| 14.10 | Алиса AI | CRM для 12 человек с WhatsApp | нет | да | 3 из 5 | нет | vc.ru, сайт конкурента |
Последняя колонка понадобится в шаге 9: из неё складывается список площадок, которым нейросети доверяют в вашей теме.
Шаг 6. Сверьте пять главных фактов о компании
Выпишите срок, цену, отрасли, интеграции и условия поддержки так, как они звучат на сайте. Затем найдите, что о вас пишут каталоги, агрегаторы, карточки на картах, старые интервью и обзоры. Расхождения отметьте в таблице из раздела выше. Партнёру или каталогу отправьте короткое письмо, его можно взять почти как есть:
Здравствуйте! В вашем каталоге в карточке компании «[название]» указан срок запуска 6 недель. Актуальные данные: запуск за 14 дней при готовом списке пользователей, подтверждение — [ссылка на кейс]. Поправьте, пожалуйста, карточку. Если удобнее, пришлю текст целиком.
Шаг 7. Допишите на сайт ответы на условия покупателя
Каждый вопрос из шага 4, на который на сайте нет ответа с цифрой, превращается в блок или страницу. Пишите абзацы по формуле «кто + что + цифра + условие», чтобы каждый читался без соседних:
Было: «Мы быстро внедряем решения под ключ с учётом специфики бизнеса».
Стало: «Компании до 20 сотрудников мы запускаем CRM за 14 дней, если список пользователей готов и старые данные переносить не нужно. С переносом из другой системы срок вырастает до 4–6 недель».
У страницы должна стоять дата обновления, а у цифр — источник: кейс, отчёт, договор.
Шаг 8. Подкрепите три главных обещания доказательствами
Выберите обещания, которые звучат на каждой встрече с клиентом, и для каждого заполните строку, как в условном примере:
| Обещание | Доказательство | Где оно опубликовано | Кто обновляет |
|---|---|---|---|
| Запуск за 14 дней | 12 внедрений за год, медиана 13 дней | кейс на сайте, статья на vc.ru | руководитель внедрения |
Если доказательства нет, обещание лучше смягчить на сайте до того, что вы можете подтвердить. Нейросеть перескажет и то и другое, но проверить покупатель сможет только второе.
Шаг 9. Выйдите на площадки, которые цитируют нейросети
Из колонки источников в шаге 5 выберите три–пять площадок, которые повторяются чаще других и где реально опубликоваться: отраслевые СМИ, vc.ru, Хабр, каталоги, сообщества с редакционным отбором. Подготовьте материал с вашими данными, условиями и ограничениями: разбор кейса, сравнение вариантов, расчёт стоимости. Пересказ того, что уже есть в интернете, нейросети не нужен.
Параллельно попросите трёх–пяти клиентов, довольных результатом, оставить отзыв на независимой площадке. Текст просьбы:
[Имя], добрый день! Мы закончили [проект] и будем благодарны за отзыв на [площадка], вот ссылка: [ссылка]. Особенно полезно, если упомянете, какую задачу решали, сколько это заняло и что получилось в итоге. Это пять минут, а нам поможет новым клиентам.
Шаг 10. Через месяц повторите замер
Задайте те же вопросы тем же системам в тех же условиях и заполните таблицу из шага 5 заново. Сравнивайте по четырём результатам отдельно: ссылки, упоминания, места в списках, рекомендации. Если результат изменился, сначала проверьте условия: модель, режим поиска, формулировку вопроса. Дальше цикл повторяется: новые пробелы из замера становятся задачами на следующий месяц.
Разметку Schema.org и файл llms.txt можно сделать на любом шаге, когда у разработчика будет свободный час. Первый результат обычно появляется в источниках и упоминаниях, рекомендация приходит позже и не всегда. Если хотите, чтобы этот путь прошли за вас, посмотрите, как устроена GEO-оптимизация в Арбузе, или оставьте заявку в форме ниже: начнём с базового замера по вашим вопросам.
Частые вопросы
Что такое GEO-оптимизация простыми словами?
Чем GEO отличается от SEO?
Как узнать, упоминает ли нейросеть мою компанию?
Нужен ли сайту файл llms.txt?
Помогает ли разметка Schema.org попасть в ответ нейросети?
Можно ли гарантировать попадание в ответы нейросетей?
Сколько ждать результата от GEO-оптимизации?
